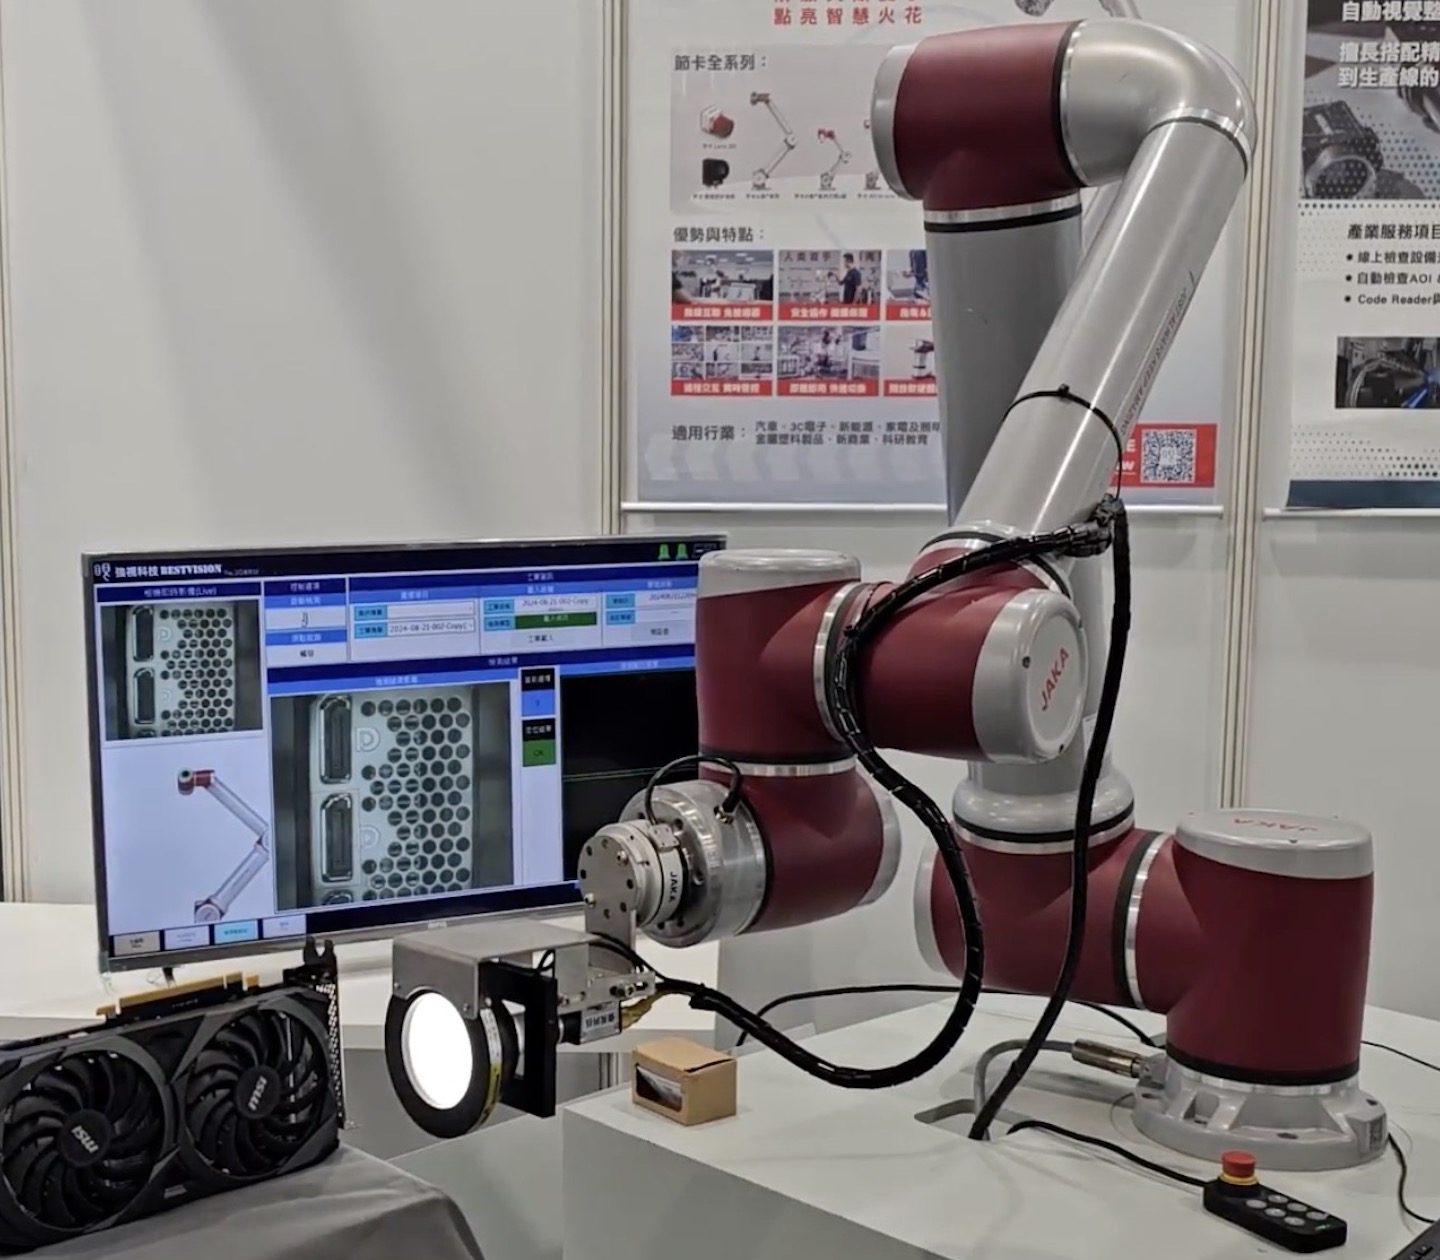
這是一條真實產線的導入縮影。起點只有幾十張缺陷影像、良品定義也還沒完全談攏。我們沒有等「樣本湊夠」才動工,而是先讓系統上線,再用三次迭代把它養起來——檢出率從 97% 一路推到 99.5%。
起點:樣本不夠,是常態不是例外
缺陷之所以叫缺陷,就是因為它不常發生。真要等到「每種缺陷都收集到上千張」,產線早就跑了半年。與其卡在資料量,不如換個思路:先用少量樣本建立可用的基準模型,再讓它在產線上邊跑邊學。
關鍵是兩件事——把良品定義先談穩(什麼叫 OK,比什麼叫 NG 更重要),以及善用資料增強,讓有限的缺陷樣本在訓練時呈現更多樣的角度、亮度與位置變化。
AI 檢測的瓶頸,多數時候不是「缺陷樣本太少」,而是「良品的標準沒講清楚」。先把 OK 的邊界定義好,模型才知道什麼算異常。
第一次迭代:先求「不漏檢」
初版模型用既有的少量缺陷樣本訓練,刻意把判定偏保守——寧可多攔、不可放過。此時檢出率約 97%,但過殺偏高,產線端會抱怨「good 也被擋下來」。這是預期中的:第一階段的目標是把漏檢壓到極低,過殺留到後面處理。
第二次迭代:把過殺餵回去
上線後,系統會自動存下每一張被判 NG 的影像。我們把其中「其實是良品卻被誤殺」的樣本挑出來、重新標註,再餵回模型。這一步等於用產線真實資料補課——模型很快就學會了「這種紋理是正常的,別大驚小怪」。過殺率明顯下降,檢出率也站上 99%。
最好的訓練資料,往往不是導入前準備的,而是上線後產線自己跑出來的。
第三次迭代:收尾那 0.5%
最後一哩通常最難。我們針對殘留的邊界案例——那些連老師傅都要看兩眼的模糊缺陷——做小批次的精修標註與再訓練。經過第三次迭代,這條產線的表現穩定在:
(由 97% 經三次迭代)
關鍵缺陷不放過
減少良品誤判
同樣重要的是導入週期:因為採「先上線、再迭代」的策略,這套系統最快 3 天就能開始在產線運作,而不是等資料齊備的數個月後。
可複製的四個步驟
- 談穩良品定義:先把「什麼算 OK」說清楚,再談缺陷分類。
- 少量樣本起步+資料增強:用有限樣本建立保守的基準模型,先確保不漏檢。
- 產線資料回灌:自動存圖,把誤殺與新缺陷重新標註、再訓練。
- 邊界案例精修:針對模糊地帶小批次迭代,收尾最後的零點幾個百分點。
不必等樣本湊滿才開始。強視的 AI 智慧訓練/檢測系統支援少量樣本訓練與持續學習,讓模型在產線上邊跑邊進化——把「資料不夠」這個最大的藉口,變成可以邊做邊解的小問題。
每條產線的缺陷都不一樣,但這套「先上線、再迭代」的方法是通用的。想知道你的產品適不適合?帶幾張缺陷影像來,我們可以先幫你評估可行性。